מרחיבים את Daybreak כשחלון הזמן להגנת סייבר מצטמצם
מציגים דרכים חדשות לגשת ליכולות סייבר מתקדמות, לצד GPT‑5.6‑Cyber, המודל הייעודי החדש ביותר שלנו לאבטחת סייבר.
עולם אבטחת הסייבר משתנה במהירות — גורמי איום ישתמשו יותר ויותר בבינה מלאכותית לביצוע מתקפות סייבר במהירות ובהיקף חסרי תקדים, לרבות באופן אוטונומי לחלוטין. ככל שהיכולות האלה מתפשטות, חלון הזמן העומד לרשות המגינים להיערכות הולך ומצטמצם. המענה שלנו הוא להעמיד בינת חזית לרשות מגינים מהימנים בכל מקום, לפני שתוקפים יפעילו יכולות תקיפה מבוססות בינה מלאכותית בקנה מידה רחב.
אנחנו מרחיבים את OpenAI Daybreak עם שתי רמות גישה, שנועדו לספק למגינים שאושרו את היכולות המתאימות לעבודתם:
Daybreak Blue מספקת גישה למודלי חזית לשימוש כללי, ובהם GPT‑5.6 Sol, עם אמצעי הגנה המותאמים לעבודת אבטחה הגנתית מורשית. זו נקודת ההתחלה המומלצת לרוב המגינים, והיא תומכת בגילוי חולשות, סקירת קוד לאבטחה, ניתוח נוזקות, תגובה לאירועים ואימות תיקוני אבטחה.
Daybreak Red מספקת גישה למודלי אבטחת הסייבר שאימנו במיוחד למחקר חולשות, אימות ניצול חולשות ובדיקות אבטחה במסגרת מורשית.
אנחנו מציגים גם את GPT‑5.6‑Cyber, הזמין דרך Daybreak Red. המודל מבוסס על GPT‑5.6 Sol ואומן לשיפור היכולות בכמה משימות ייעודיות באבטחת סייבר (למשל, איתור חולשות יום אפס ופיתוח שרשראות ניצול), ולהפחתת סירובים במשימות סייבר מסוימות בסיכון גבוה יותר, שיש להן שימוש הגנתי והתקפי כאחד.
Daybreak פותחת גישה ליכולות סייבר מתקדמות
כפי ששיתפנו בעבר, GPT‑5.6 Sol מציג ביצועים מהמובילים בתחום במשימות אבטחת סייבר. בסביבת הייצור אנחנו מפעילים אמצעי הגנה ברמת המערכת לסינון בקשות הקשורות לאבטחת סייבר כדי למנוע שימוש לרעה, אך הם עלולים לחסום גם עבודת הגנה לגיטימית. הגישה דרך Daybreak Blue מסירה את המגבלות האלה, ומסייעת למגינים להפיק יותר מהמודל במשימות אבטחה בעולם האמיתי, ובהן זיהוי אירועים ותגובה להם, חקירות, ניהול חולשות והערכות אבטחה.
גם ללא מגבלות ברמת המערכת, עדיין יש פרומפטים בתחום אבטחת הסייבר בעלי פוטנציאל מובהק לשימוש הגנתי והתקפי כאחד (למשל, בדיקות חדירה למערכות ייצור), ש-GPT‑5.6 Sol יסרב לבצע. כדי לתת לכך מענה, אימנו את GPT‑5.6‑Cyber, הזמין בגישה דרך Daybreak Red, להפחית עוד יותר את הסירובים ולשפר את הביצועים במשימות מסוימות. GPT‑5.6‑Cyber מסייע למגינים מהימנים לבצע פעילויות אבטחה לגיטימיות.
כדי למדוד את הירידה בשיעור הסירובים שמאפשר GPT‑5.6‑Cyber בגישה דרך Daybreak Red, יצרנו הערכה פנימית (שיעור השלמה במשימות אבטחת סייבר מתקדמות), המודדת באיזו תדירות מודלים נענים לבקשות הכוללות פיתוח שרשראות ניצול, עקיפת אימות, הסלמת הרשאות ותרחישי אבטחת סייבר מתקדמים נוספים1. GPT‑5.6‑Cyber משלים 95.0% מהבקשות האלה, לעומת 1.5% בלבד ב-GPT‑5.6 Sol ו-2.0% בשימוש בו בגישה דרך Daybreak Blue. הוא גם משלים יותר בקשות מ-GPT‑5.5‑Cyber, שמשלים רק 57.3% מהבקשות, ובכך נותן מענה למשוב מחוקרי אבטחה שנתקלו בסירובים חוזרים ונשנים במודל הקודם.
להלן סדרה של פרומפטים בתחום אבטחת הסייבר, לצד התשובות של GPT‑5.6 Sol עם מגבלות ברמת המערכת, GPT‑5.6 Sol (Daybreak Blue), GPT‑5.5‑Cyber (Daybreak Red) ו-GPT‑5.6‑Cyber (Daybreak Red).
שיפור הביצועים באבטחת סייבר
המודל GPT‑5.6‑Cyber מאומן לשיפור הביצועים בתהליכי אבטחת סייבר מסוימים, הכוללים פיתוח קוד לניצול חולשות ומחקר אבטחה מתקדם. ב-ExploitGym2, שבודק אם סוכנים יכולים להפוך חולשות מוכרות לקוד ניצול פעיל שמאפשר הרצת קוד שרירותי בסביבות מבוקרות, GPT‑5.6‑Cyber מציג ביצועים טובים יותר הן מ-GPT‑5.6 Sol והן מ-GPT‑5.5 Cyber.
תחום נוסף ש-GPT‑5.6‑Cyber נועד לשפר הוא היכולת לאתר חולשות יום אפס חדשות ולהעריך במדויק את חומרתן. יצרנו מערך נתונים להערכה פנימית, שבו אנחנו מספקים למודלים את הגרסה העדכנית של מאגר קוד פתוח. לאחר מכן אנחנו מבקשים מהם ליצור קוד לניצול חולשות כהוכחת היתכנות, עם ההשפעה המרבית האפשרית, לצד דוח טכני על הממצאים. המודלים מוערכים לפי חומרת הממצאים והשפעתם, וכן לפי איכות הדוח הטכני הנלווה והמידה שבה ההערכות בו תואמות את הממצאים בפועל. GPT‑5.6‑Cyber (Daybreak Red) הציג במבחן זה ביצועים טובים יותר מ-GPT‑5.6 Sol (Daybreak Blue), בזכות האימון הייעודי שלו.
הערכנו את GPT‑5.6‑Cyber גם בהערכה הפנימית שלנו לגילוי חולשות וכתיבת דוחות, שבה סוכן מקבל פרומפט פתוח לאיתור חולשות במאגר שיש בו חולשה ידועה. מודלים צוברים נקודות בהערכה זו באמצעות איתור חולשות חמורות שניתן לפעול לטיפול בהן (חדשות או מוכרות), פיתוח הוכחת היתכנות פעילה והגשת דוח חולשה באיכות גבוהה. גם GPT‑5.6 Sol וגם GPT‑5.6‑Cyber מציגים שיפור לעומת GPT‑5.5‑Cyber. הביצועים של GPT‑5.6‑Cyber בהערכה זו נמוכים מאלה של GPT‑5.6 Sol. להערכתנו, הסיבה לכך היא שהמודל מפיק לעיתים דוחות חולשה קצרים ומפורטים פחות.
לבסוף, מדדנו יכולות פיתוח קוד לניצול חולשות באמצעות ExploitBench3, הערכה שבודקת את יכולתו של סוכן להפוך חולשה ב-V8 לקוד ניצול מלא. משימת ניצול החולשה הזו קשה יותר מ-ExploitGym — אמצעי הגנה רבים יותר, כמו ארגז החול של V8, נשארים פעילים, והסוכן מקבל פחות מידע על החולשה שעליו לנצל. בתצורה הסטנדרטית, שמגבילה סוכנים ל-300 תורות, GPT‑5.6 Sol (Daybreak Blue) פותר משימות ביעילות גבוהה יותר מבחינת שימוש בטוקנים ומציג את הביצועים הטובים ביותר. אם מרחיבים את המגבלה הסטנדרטית מ-300 ל-600 תורות, פער הביצועים בין שני המודלים מצטמצם.
מעבר לתוצאות במבחני ההערכה, הענקנו גם גישה מוקדמת ל-GPT‑5.6‑Cyber לקבוצת לקוחות מהימנים השותפים שלנו. הלקוחות האלה השתמשו במודלים בהצלחה רבה כדי להאיץ את תהליכי ההגנה שלהם:
איתור ותיקון חולשות בתוכנות בעולם האמיתי
היכולות של GPT‑5.6‑Cyber אינן מסתכמות בביצועים במבחני מחקר, אלא באות לידי ביטוי גם במחקר חולשות בעולם האמיתי. מחקר חולשות בעולם האמיתי דורש לעיתים קרובות reasoning מתמשך על פני בסיסי קוד גדולים ולא מוכרים. על החוקרים לגבש השערות ולבחון אותן, לעקוב אחר יחסי הגומלין בין רכיבים רבים, לשחזר התנהגות בלתי צפויה ולקבוע אם אפשר לנצל בפועל חולשה חשודה.
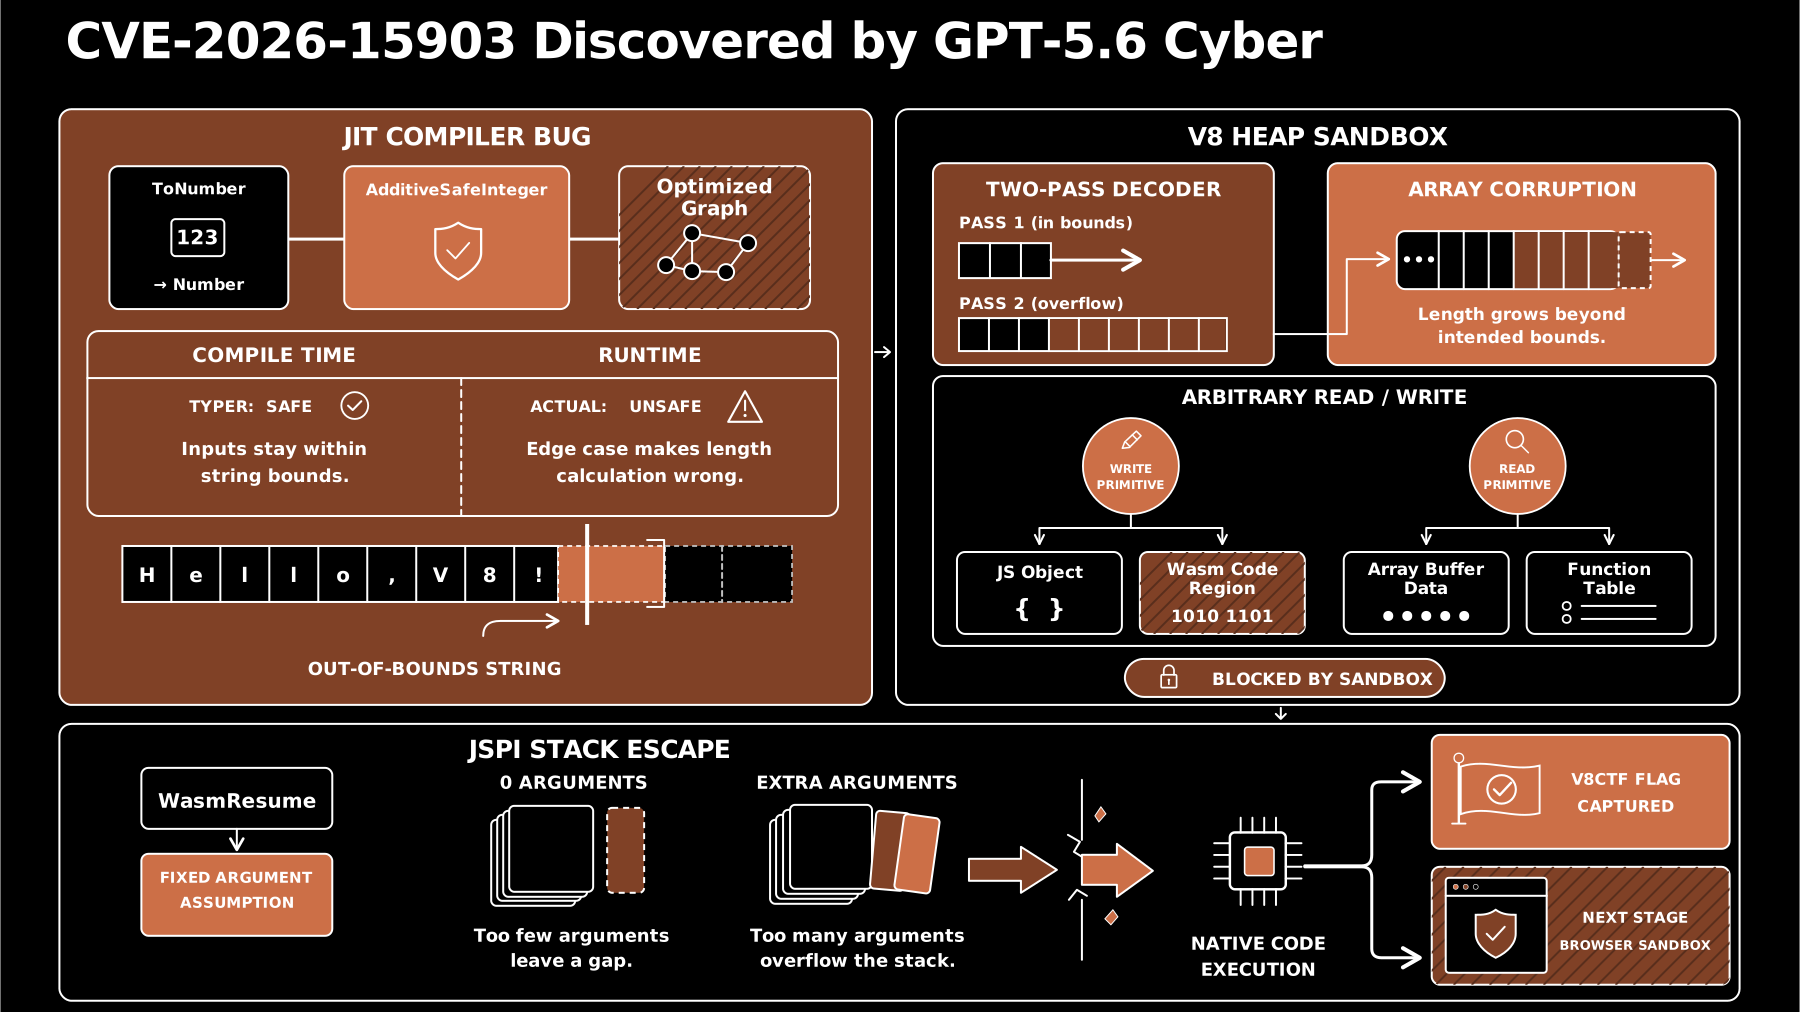
מאז שהסתיים האימון של המודל GPT‑5.6‑Cyber, השתמשנו בו כדי לחקור לעומק פרויקטי תוכנה נבחרים ולשפר אותם. לדוגמה, השתמשנו ב-GPT‑5.6‑Cyber כדי לחקור את V8, מנוע ה-JavaScript של Chrome. גילינו שתי חולשות שלא היו מוכרות קודם לכן, ושאפשר היה לשרשר ביניהן כדי להשחית זיכרון ולצאת מארגז החול של ערמת הזיכרון ב-V8. החוקרים שלנו אימתו את הממצאים ודיווחו עליהם ל-Google במסגרת תהליך מתואם של חשיפת חולשות. Google תיקנה את החולשה והקצתה לה את המזהה CVE-2026-15903.
CVE-2026-15903 היא חולשה בדרגת חומרה גבוהה ב-V8, מנוע ה-JavaScript של Chrome. המהדר שלו, שמבצע אופטימיזציה, דילג בטעות על בדיקת בטיחות בעת המרת ערכים למספרים שלמים. כתוצאה מכך, ערכים לא מוגדרים יכלו להפיק מספר גדול באופן בלתי צפוי במקום התוצאה הצפויה.
אם המספר הזה משמש כאינדקס במערך, המהדר עלול להניח בטעות שהוא נמצא בגבולות המערך ולהשמיט את בדיקת הגבולות הרגילה. כך תוקף יכול לקרוא או לדרוס זיכרון ששייך לאובייקטים אחרים, ובאופן פוטנציאלי להריץ קוד שרירותי בתוך ארגז החול של Chrome. כדי לצאת מארגז החול של ערמת הזיכרון נדרשת בדרך כלל חולשה שנייה, שגם אותה מצא GPT‑5.6‑Cyber. התרשים הבא מציג סקירה של החולשה הזו, שדרגת חומרתה גבוהה.
מלבד החולשות האלה ב-V8, השתמשנו ב-GPT‑5.6‑Cyber גם לאיתור בעיות בדרגת חומרה גבוהה בתוכנות מסוגים שונים, ממסדי נתונים נפוצים ועד טלפונים ניידים:
לפחות חמש חולשות במערכת הפעלה נפוצה למכשירים ניידים, ובהן שרשרת שמתחילה באפליקציה לא מהימנה ומובילה להסלמת הרשאות מקומית.
שלוש חולשות קריטיות במסד נתונים נפוץ, ובהן דרך להרצת קוד מרחוק.
יותר מ-400 חולשות שעלולות להוביל להסלמת הרשאות בליבה של מערכת הפעלה נפוצה.
אנחנו עובדים בשיתוף פעולה הדוק עם שותפי Daybreak ועם חברי קהילת הקוד הפתוח כדי לדווח על החולשות האלה במערכת ההפעלה לניידים, במסד הנתונים ובליבה, ולתקן אותן.
הערכות מוכנות
במסגרת Preparedness Framework שלנו, המודל GPT‑5.6 Sol הוערך כבעל יכולת אבטחת סייבר ברמה גבוהה, אך מתחת לסף הקריטי. לפני השקת GPT‑5.6‑Cyber, הערכנו גם את יכולות הסייבר שלו שבחזית הטכנולוגיה, וקבענו שגם הוא מגיע לסף הגבוה, אך לא לסף הקריטי. המודל הציג שיפור לעומת GPT‑5.6 Sol בכמה משימות סייבר ייעודיות שאימנו אותו לבצע במישרין, אך לא במידה שמגיעה לסף הקריטי שלנו. שימו לב שכפי שציינו בעדכונים שלנו בנוגע לתקרית Hugging Face, GPT‑5.6‑Cyber לא היה מעורב בניצול החולשה ב-Hugging Face, וגם לא מודלים אחרים המיועדים להשקה בקרוב.
בהמשך נפרסם כרטיס מערכת עם הערכות נוספות של GPT‑5.6‑Cyber.
גישה ואמצעי הגנה
מודלים שפועלים עם אמצעי הגנה מצומצמים כרוכים בסיכונים מעבר לאלה שבשימוש רגיל במודל, בין שבשל שימוש לרעה ובין שבשל אי-התאמה לכוונות שהוגדרו. למרות הסיכונים האלה, אנחנו מאמינים שהרחבת הגישה לבינת חזית עבור מגינים חיונית להאצת הגנת הסייבר ולהפיכתה לאוטומטית.
גישה דרך Daybreak Blue ו-Daybreak Red זמינה ליחידים(נפתח בחלון חדש) ולארגונים שאושרו ועוסקים בפעילות מורשית. אנחנו מבקרים את הגישה באמצעות אימות זהות, אבטחת חשבונות, ניטור, הגבלת השימוש למטרות שאושרו והצהרות משפטיות.
אנחנו נוקטים גם צעדים נוספים כדי לאפשר שימוש בטוח יותר במודלי סייבר:
אנחנו מעודדים בחום את לקוחות Daybreak המשתמשים ב-Codex לעבור ממצב גישה מלאה למצב סקירה אוטומטית, באמצעות ברירות המחדל באפליקציה ותכונות בממשק המשתמש. סקירה אוטומטית בוחנת פעולות הדורשות הרשאות מוגברות לפני ביצוען, ויכולה לחסום בקשות הכרוכות בסיכון משמעותי להתנהגות הרסנית.
החל מ-1 בספטמבר 2026, נחייב את כל בעלי החשבונות האישיים ב-Daybreak להשתמש במפתחות אבטחה פיזיים.
אנחנו פועלים לפיתוח אמצעי אבטחה נוספים, ובהם ניטור משופר, שבכוונתנו להפעיל בשבועות הקרובים.
אנחנו נותנים עדיפות לאימון ולבדיקות להתאמת המודלים לכוונות שהוגדרו, לקראת הגרסאות הבאות של Daybreak.
עדכנו את התיעוד של Codex בנושא נוהלי בטיחות מומלצים, כדי לעזור לצוותים לשמור סוכנים בעלי יכולות סייבר בתוך גבולות האבטחה שנקבעו להם.
נוהלי העבודה המומלצים לשימוש בסדרת Daybreak כוללים:
הפעילו בארגז חול ובודדו. הפעילו תהליכי אבטחה בסביבות מבוקרות, ללא גישה למערכות ייצור רגישות או לאינטרנט הפתוח. בדקו בקביעות את גבולות ארגז החול.
נטרו את פעולות הסוכן. השתמשו במצב סקירה אוטומטית(נפתח בחלון חדש) כדי לבדוק קריאות לכלים מחוץ לארגז החול של Codex לפני ביצוען. הוסיפו ניטור ופיקוח אנושי לתהליכי עבודה בסיכון גבוה יותר.
הגדירו את גבולות הפעילות. ציינו באילו מערכות מותר לפעול ואילו פעולות מותר לבצע. השתמשו בפרופילי הרשאות מוגבלי היקף(נפתח בחלון חדש) כדי לאכוף את הגבולות האלה.
ארגונים יכולים גם להתאים את מדיניות הסקירה(נפתח בחלון חדש) לתהליכי העבודה הספציפיים שלהם.
אנחנו ממליצים על Daybreak Blue כנקודת ההתחלה לרוב המגינים. צוותים שעבודתם המורשית כוללת מחקר חולשות מתקדם, פיתוח קוד לניצול חולשות או red teaming יכולים לבקש גישה דרך Daybreak Red למודלי הסייבר המתקדמים ביותר שלנו. להגשת בקשת הצטרפות לתוכנית, היכנסו אל openai.com/daybreak/partners.
1. בכל ההערכות מוצגים הביצועים של כל מודל ברמת ה-reasoning הגבוהה ביותר הזמינה לציבור. שימו לב ש-GPT‑5.6‑Cyber נוטה להקדיש ל-reasoning תקציב גדול יותר מזה של GPT‑5.6 Sol, ולכן משתמש ביותר טוקנים.
2. כל הערכות ExploitGym נערכו באמצעות המימוש הפנימי החדש שלנו בסביבות מבודדות ומוקשחות מבחינת אבטחה, תוך ניטור קפדני של התנהגויות שאינן תואמות את הכוונות שהוגדרו.
3. הערכות ExploitBench נערכו באמצעות המימוש הפנימי שלנו בסביבות מבודדות ומוקשחות מבחינת אבטחה.


