סרטון מואץ של GPT‑5.6 Sol מנסה לפתור חידות במבחן ההערכה ARC-AGI-3, עם ה-harness הרשמי (משמאל) ועם ה-harness שלנו המבוסס על Responses API (מימין), שמשמר reasoning ומאפשר compaction. בטבלת הדירוג של המשחק הזה(נפתח בחלון חדש), אף מודל חזית לא מצליח לפתור שלב מעבר לראשון. עם ה-harness שלנו, GPT‑5.6 Sol פותר את כל ששת השלבים.
כשראינו לראשונה את הציונים הנמוכים של GPT‑5.6 Sol במבחן ההערכה ARC-AGI-3(נפתח בחלון חדש), לא הבנו מה הסיבה.
GPT‑5.6 Sol פתר בעיות מתמטיות שנותרו פתוחות שנים רבות, כמו השערת הכיסוי הכפול במעגלים(נפתח בחלון חדש), והשלים משחקים כמו Pokémon FireRed. אבל ב-ARC-AGI-3, מבחן הערכה המבוסס על משחקי חידות דו-ממדיים, GPT‑5.6 Sol קיבל ציון של 7.8% בלבד, ו-GPT‑5.5 בקושי הצליח לשחק במשחקים בכלל, עם ציון זעום של 0.4%.
האם משחקי חידות דו-ממדיים היו קשים במיוחד למודלים שלנו? או שמשהו אחר קרה כאן?
מבחני הערכה כמעט אף פעם אינם מודדים מודלים של בינה מלאכותית במנותק מסביבת ההפעלה שלהם. הם מודדים גם את השפעתן של בחירות פחות גלויות לעין בנוגע להגדרות API, לתכנון ה-harness ולניסוח הפרומפטים. במקרה של ARC-AGI-3, גילינו שהפעלת שתי הגדרות API שבהן אנו משתמשים ב-ChatGPT וב-Codex — שימור reasoning ו-compaction — שילשה את הציונים והפחיתה פי 6 את מספר טוקני הפלט במערך המשימות הציבורי.
עם ה-harness הרשמי, GPT‑5.6 Sol קיבל ציון של 13.3% במערך המשימות הציבורי של ARC-AGI-3. עם שימור reasoning ו-compaction, הוא קיבל ציון של 38.3%. הציונים מודדים יעילות פעולות ביחס לבני אדם (RHAE(נפתח בחלון חדש))—מדד המשווה את ביצועי המודל לנקודת ייחוס אנושית. על סמך יומני המשחק הרשמיים(נפתח בחלון חדש), אנו מעריכים שהציון הממוצע של הבודקים האנושיים היה 48%. למודלים לא נאמר כיצד ייקבע הציון שלהם, והם אינם יכולים לראות אותו לאורך המשחק—כל פעולה מחזירה רק ייצוג טקסטואלי של כל פריים ואת השלב שבו הם נמצאים.
ARC-AGI-3 הוא מבחן הערכה שנועד למדוד עד כמה סוכני בינה מלאכותית מסוגלים ללמוד ולהסיק מסקנות. הסוכנים חוקרים משחקים דו-ממדיים לא מוכרים ומבינים כיצד הם פועלים, ללא הוראות מפורשות. אפשר לשחק ב-25 משחקי הדגמה בכתובת arcprize.org/tasks(נפתח בחלון חדש).
ARC-AGI-3 משתמש ב-harness כללי במכוון, ללא כלים או תכונות מיוחדות. ההיגיון של ARC היה ש-harness פשוט מבליט את החסרונות של המודלים ומאפשר השוואה הוגנת יותר ביניהם. לעומת זאת, מפתחים מסחריים מתאימים את ה-harness לתכונות ולמאפיינים הייחודיים של כל מודל כדי להשיג ביצועים מיטביים.
בתחום המשחקים, GPT‑5.6 Sol השלים את Pokémon FireRed עם harness המבוסס על קלט חזותי בלבד (כפי ששודר ב-GPT_Plays_Pokemon(נפתח בחלון חדש)), את Slay the Spire באמצעות יכולת השימוש במחשב של Codex (כפי ששודר ב-EpochAI(נפתח בחלון חדש)), ואת השלבים הראשונים של Baba Is You (כפי ששיתפו פיוטר מיגדל ופיוטר גרבובסקי(נפתח בחלון חדש)). מה היה כל כך שונה ב-ARC-AGI-3?
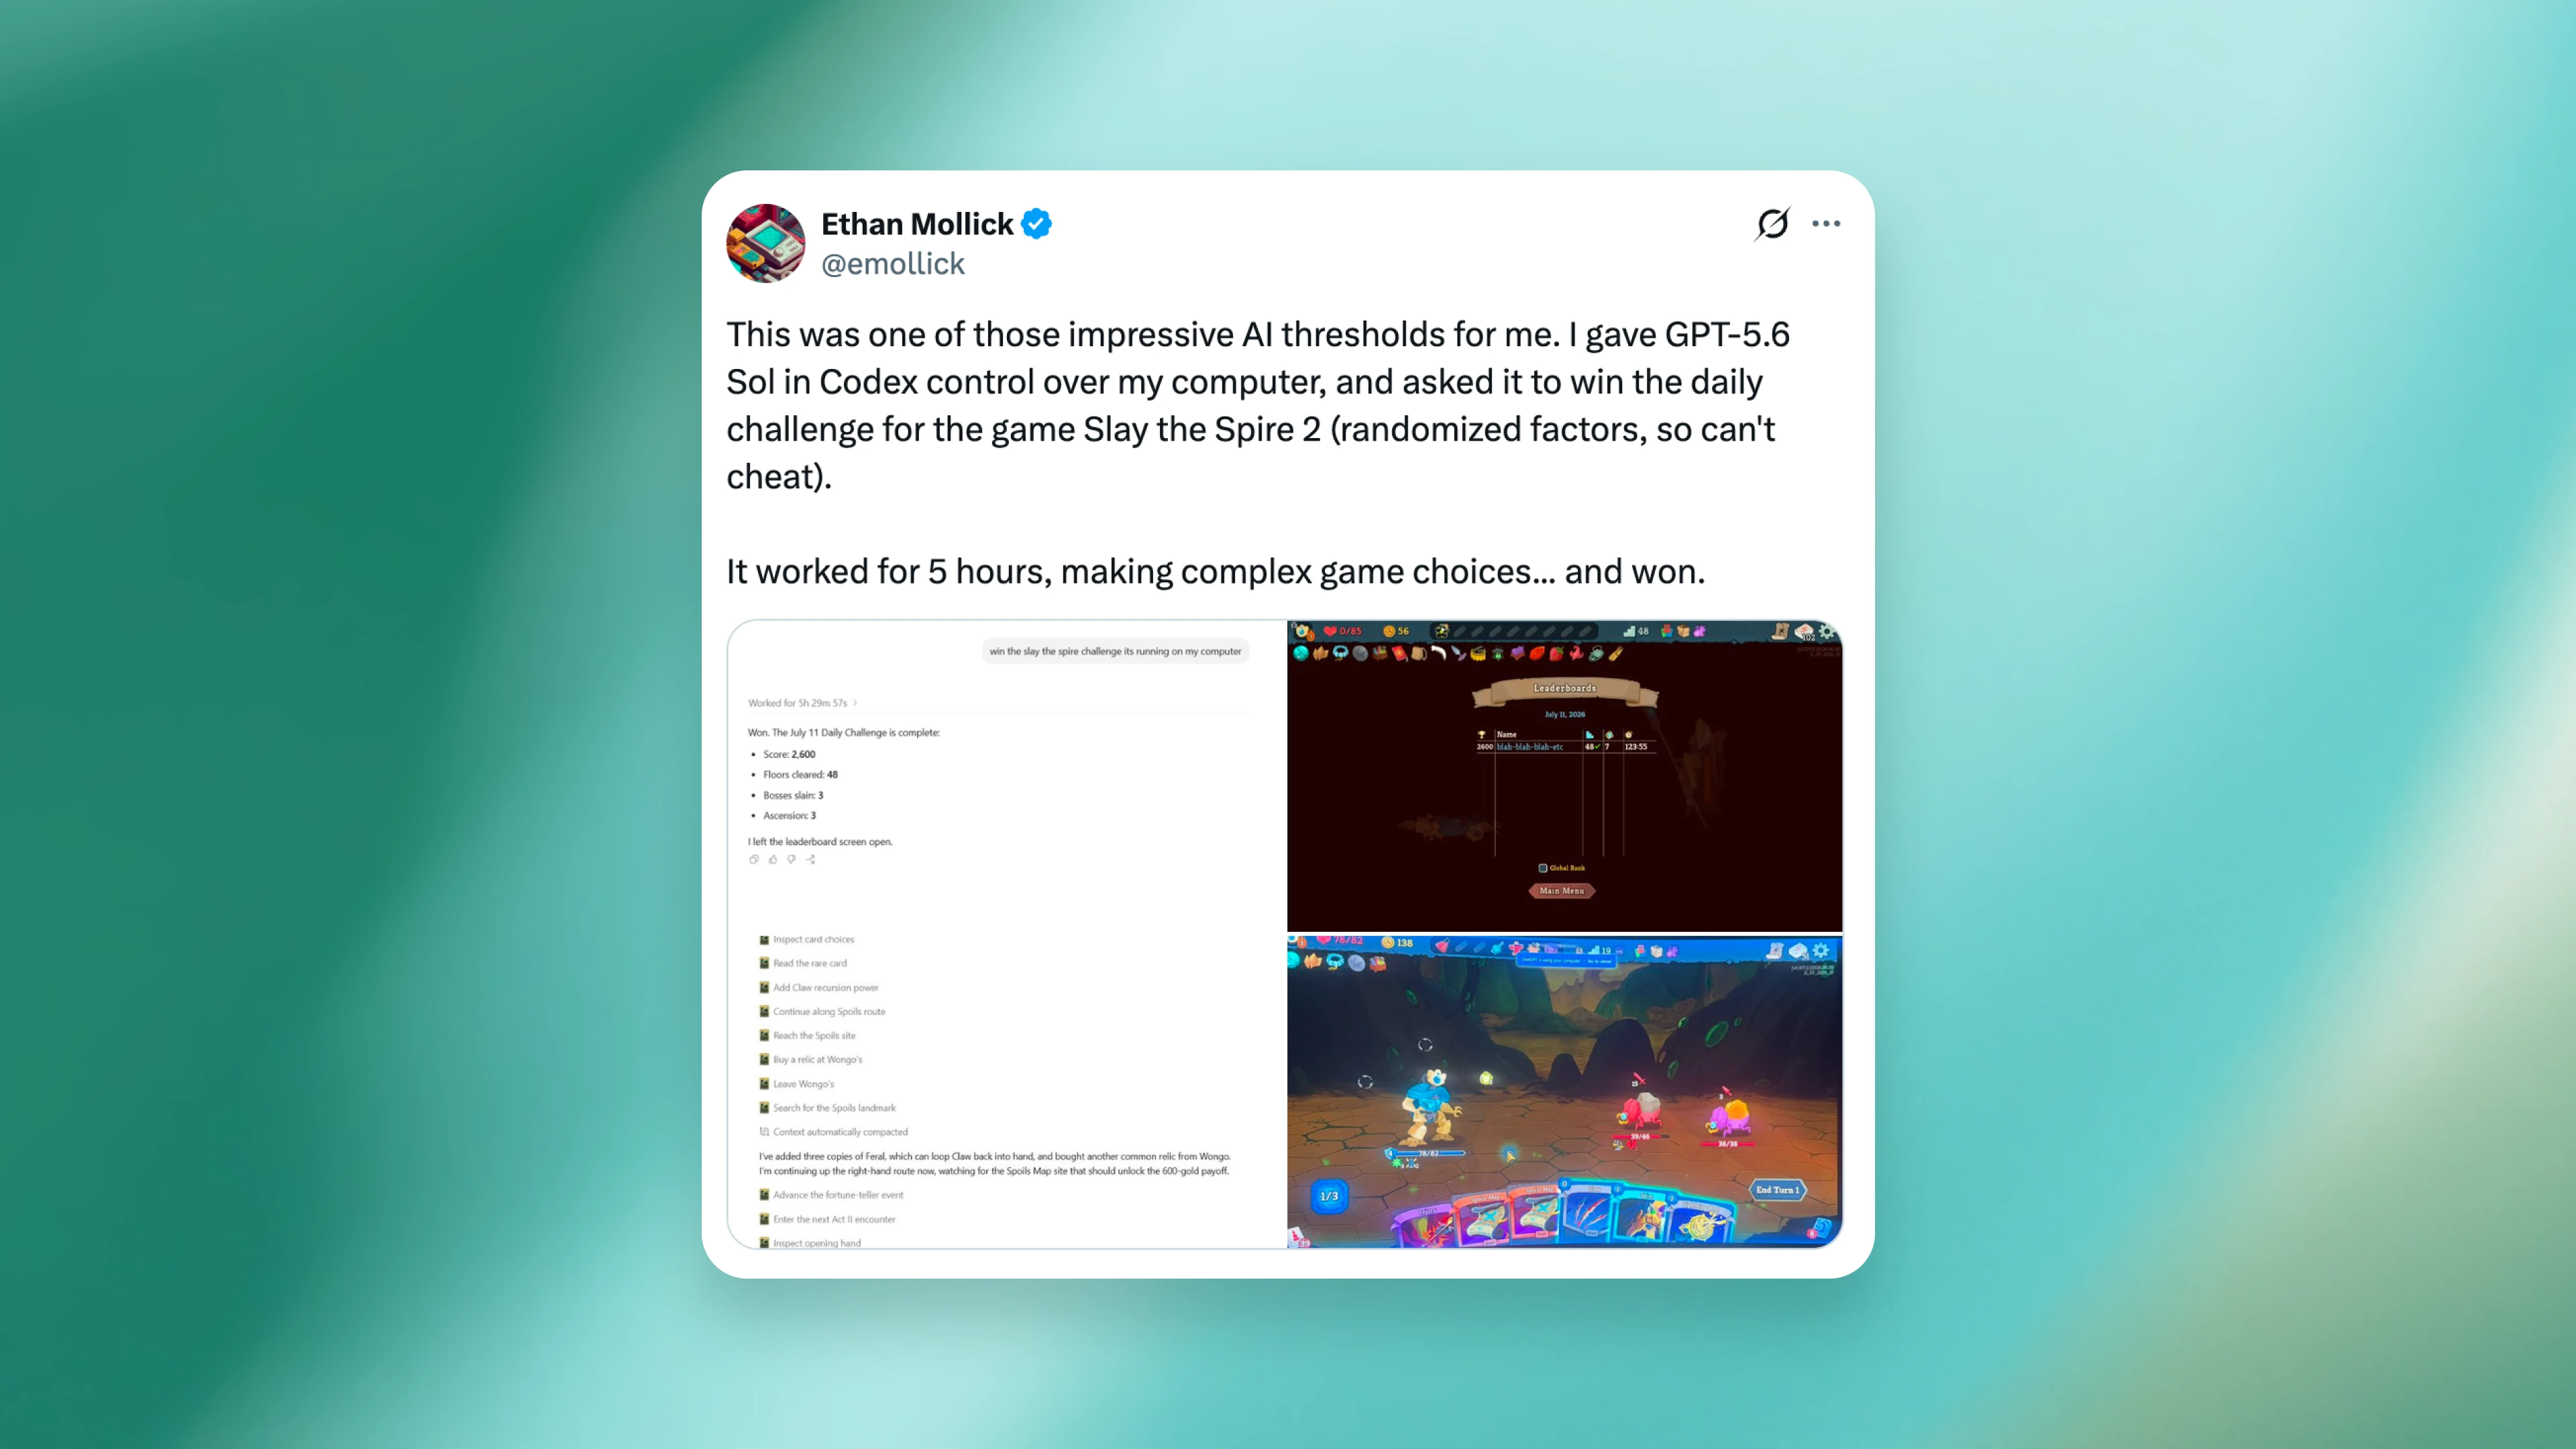
איתן מוליק מציג(נפתח בחלון חדש) את GPT‑5.6 Sol ב-Codex משלים אתגר יומי אקראי ב-Slay the Spire 2, משחק שיצא אחרי תאריך סף הידע של GPT‑5.6 Sol.
בהשראת הניתוח של ARC על החסרונות של GPT‑5.5(נפתח בחלון חדש), בחנו כמה מניסיונות המשחק של GPT‑5.6 Sol. כמו ARC, גם אנחנו ראינו שהמודל לא הפגין חוכמה רבה. הוא התעכב זמן רב על כל פעולה והתקשה להתקדם.
אבל ככל שהעמקנו בבדיקה, גילינו שחלק גדול מהבלבול של המודל לא נבע ממגבלה מהותית שלו, אלא מהגדרות ב-harness.
ראשית, שמנו לב שאחרי כל פעולה במשחק, כל ה-reasoning הפנימי נמחק. המשמעות הייתה שבכל פעולה, GPT‑5.6 Sol נדרש להבין את המשחק מחדש, בלי יכולת לזכור את המחשבות הקודמות שלו. המודל עדיין יכול היה לראות תיעוד של מהלכים קודמים והערות קצרות שנלוו אליהם, אבל לא את התוכניות, התובנות או המחשבות שהובילו אליהם.
שנית, ראינו שה-harness השתמש בחלון חיתוך מתגלגל, שגרם לפעולות ישנות להיעלם מעיני המודל ככל שההיסטוריה התארכה. כך שלא רק ש-GPT‑5.6 Sol לא יכול היה לזכור את המחשבות הקודמות שלו, הוא גם איבד את הזיכרון של פעולותיו הקודמות.
יחד, שני המאפיינים האלה של ה-harness — מחיקת reasoning וחיתוך מתגלגל — עזרו להסביר מדוע GPT‑5.6 Sol התקשה ללמוד לאורך זמן.
המודלים שלנו מאומנים לחשוב באמצעות הודעות reasoning פנימיות לפני שהם מפיקים תשובות או קריאות לכלים. הודעות החשיבה הפנימיות האלה נשמרות כחלק מהיסטוריית השיחה. אם שיחה מתארכת יותר מדי, אנחנו מסכמים אותה וממשיכים.

כך המודלים שלנו מאומנים, וכך הם גם מופעלים ב-ChatGPT וב-Codex. כדי להתאים טוב יותר לסביבת הייצור שלנו, מימשנו את ה-harness של ARC-AGI-3 באמצעות Responses API(נפתח בחלון חדש) שלנו. ה-API שלנו מקל על ניהול ההקשר: ב-GPT‑5.6, העברת מזהה התגובה הקודמת משמרת אוטומטית את ה-reasoning בין קריאות לכלים ובין תורות בשיחה.
לאחר שה-reasoning נשמר, הבחנו בשני שינויים משמעותיים. ראשית, GPT‑5.6 Sol הקדיש פחות זמן לחשיבה לפני כל פעולה, כי הוא כבר לא נדרש להבין את המשחק מאפס בכל תור. שנית, כשהצליח לזכור את מחשבותיו הקודמות, GPT‑5.6 Sol למד טוב הרבה יותר לאורך זמן ויישם אסטרטגיות עקביות יותר.
השיפור הבא הגיע מהחלפת החיתוך המתגלגל ב-compaction(נפתח בחלון חדש), הגדרה נוספת ב-Responses API.
ה-harness של ARC-AGI-3 מתמודד עם מגבלות ההקשר באמצעות חיתוך מתגלגל. כשהקשר השיחה חורג מ-175,000 תווים, ההודעות הישנות ביותר נמחקות.
לחיתוך מתגלגל יש שני חסרונות. ראשית, המודל מאבד מידע על תצפיות ופעולות קודמות. שנית, לאורך חלק ניכר מהמשימות הוא פועל עם חלון הקשר מלא יותר, מה שעלול לפגוע מעט בביצועים.
כשהפעלנו compaction ב-ARC-AGI-3, GPT‑5.6 Sol הצליח לשמר טוב יותר את מה שלמד על כל משחק לאורך ריצות ממושכות יותר, והשיג ציון גבוה יותר עם פחות טוקני פלט.
כדי להמחיש את ההשפעה של שימור reasoning והפעלת compaction, הנה אנימציה המציגה את חלון ההקשר של GPT‑5.6 Sol, בגודל 175 אלף טוקנים, בזמן שהוא פותר סדרת חידות של ARC-AGI-3 עם כל אחד משני סוגי ה-harness.
שתי העמודות המרכזיות מציגות את ההבדל באופן השימוש בחלון ההקשר של המודל בין שני סוגי ה-harness. כש-GPT‑5.6 Sol זוכר טוב יותר את העבר, הוא חושב פחות בכל פעולה ומתקדם הרבה יותר מהר. הערה: המימוש שלנו משתמש במגבלה של 175,000 טוקנים במקום תווים, אבל בפועל התוצאה דומה למדי, משום שהרוב המכריע של הטקסט מורכב מרשתות משחק המתעדות את הפעולות, ומנגנון החלוקה שלנו לטוקנים ממיר אותן ביחס של 1:1.
יחד, שימור reasoning ו-compaction מאפשרים ל-GPT‑5.6 Sol (מקסימלית) להשיג ציון גבוה פי 3 בקירוב, עם פי 6 פחות טוקני פלט.
אנו מקווים שהניסויים האלה יזכירו שמבחני הערכה כמעט אף פעם אינם מודדים מודלים במנותק מסביבת ההפעלה שלהם — הם מודדים גם את השפעתן של מגוון בחירות פחות גלויות לעין בנוגע להגדרות API, לתכנון ה-harness ולניסוח הפרומפטים. זו לא הפעם הראשונה שהופתענו מציונים נמוכים במבחן הערכה ציבורי, ואז גילינו שמערכת הרצת המבחן השתמשה ב-harness כללי שמחק הודעות reasoning.
אם אתם מפתחים באמצעות ה-API ורוצים להשיג ביצועים מיטביים, אנו ממליצים להשתמש באותן הגדרות שבהן אנו משתמשים במוצרים שלנו:
השתמשו ב-Responses API שלנו, ולא ב-API להשלמת צ'אטים הישן שלנו
שמרו את ה-reasoning
השתמשו ב-compaction
ואם אתם משווים בין מודלים, אנו ממליצים להסתמך על מבחני הערכה שמשתמשים בהגדרות האלה, המשקפות בצורה הטובה ביותר את השימוש בפועל ב-ChatGPT וב-Codex.
אנו מודים ל-ARC על שנים של עבודה יצירתית בתחום הערכת AGI, ועל הניתוח שלהם שעודד אותנו לבחון את המקרה הזה לעומק.
אם תרצו לבחון את היכולות שלכם מול מודלי חזית, נסו בעצמכם את המשחקים הפתוחים לציבור בכתובת arcprize.org/tasks(נפתח בחלון חדש).


