Izstrādātāja ceļvedis par GPT‑5.6
Tehniskās atziņas no jaunuzņēmumiem produkcijas vidē
GPT‑5.6 modeļu saime padara robežšķirtnes līmeņa aģentu veiktspēju daudz pieejamāku, vienlaikus paplašinot iespējamā robežas.
Šajā ceļvedī parādām, kā jaunuzņēmumi ar pārdomātāku modeļu izvēli un jaunām API vadīklām, kas palīdz saglabāt spriestspējas nepārtrauktību, orķestrēt vairākus aģentus un programmatiski izsaukt rīkus, veido ātrākus un spējīgākus aģentus par daudz zemākām izmaksām.
Kopš GPT‑5 katras paaudzes modeļu mērķis ir bijis ar mazāk tekstvienībām izpildīt uzdevumus, kuriem vajadzīga ilgāka darbība. GPT‑5.6 turpina šo virzību: labāka aģentu veiktspēja un zemākas izmaksas, turklāt izpildes ietvars jāmaina pavisam nedaudz.
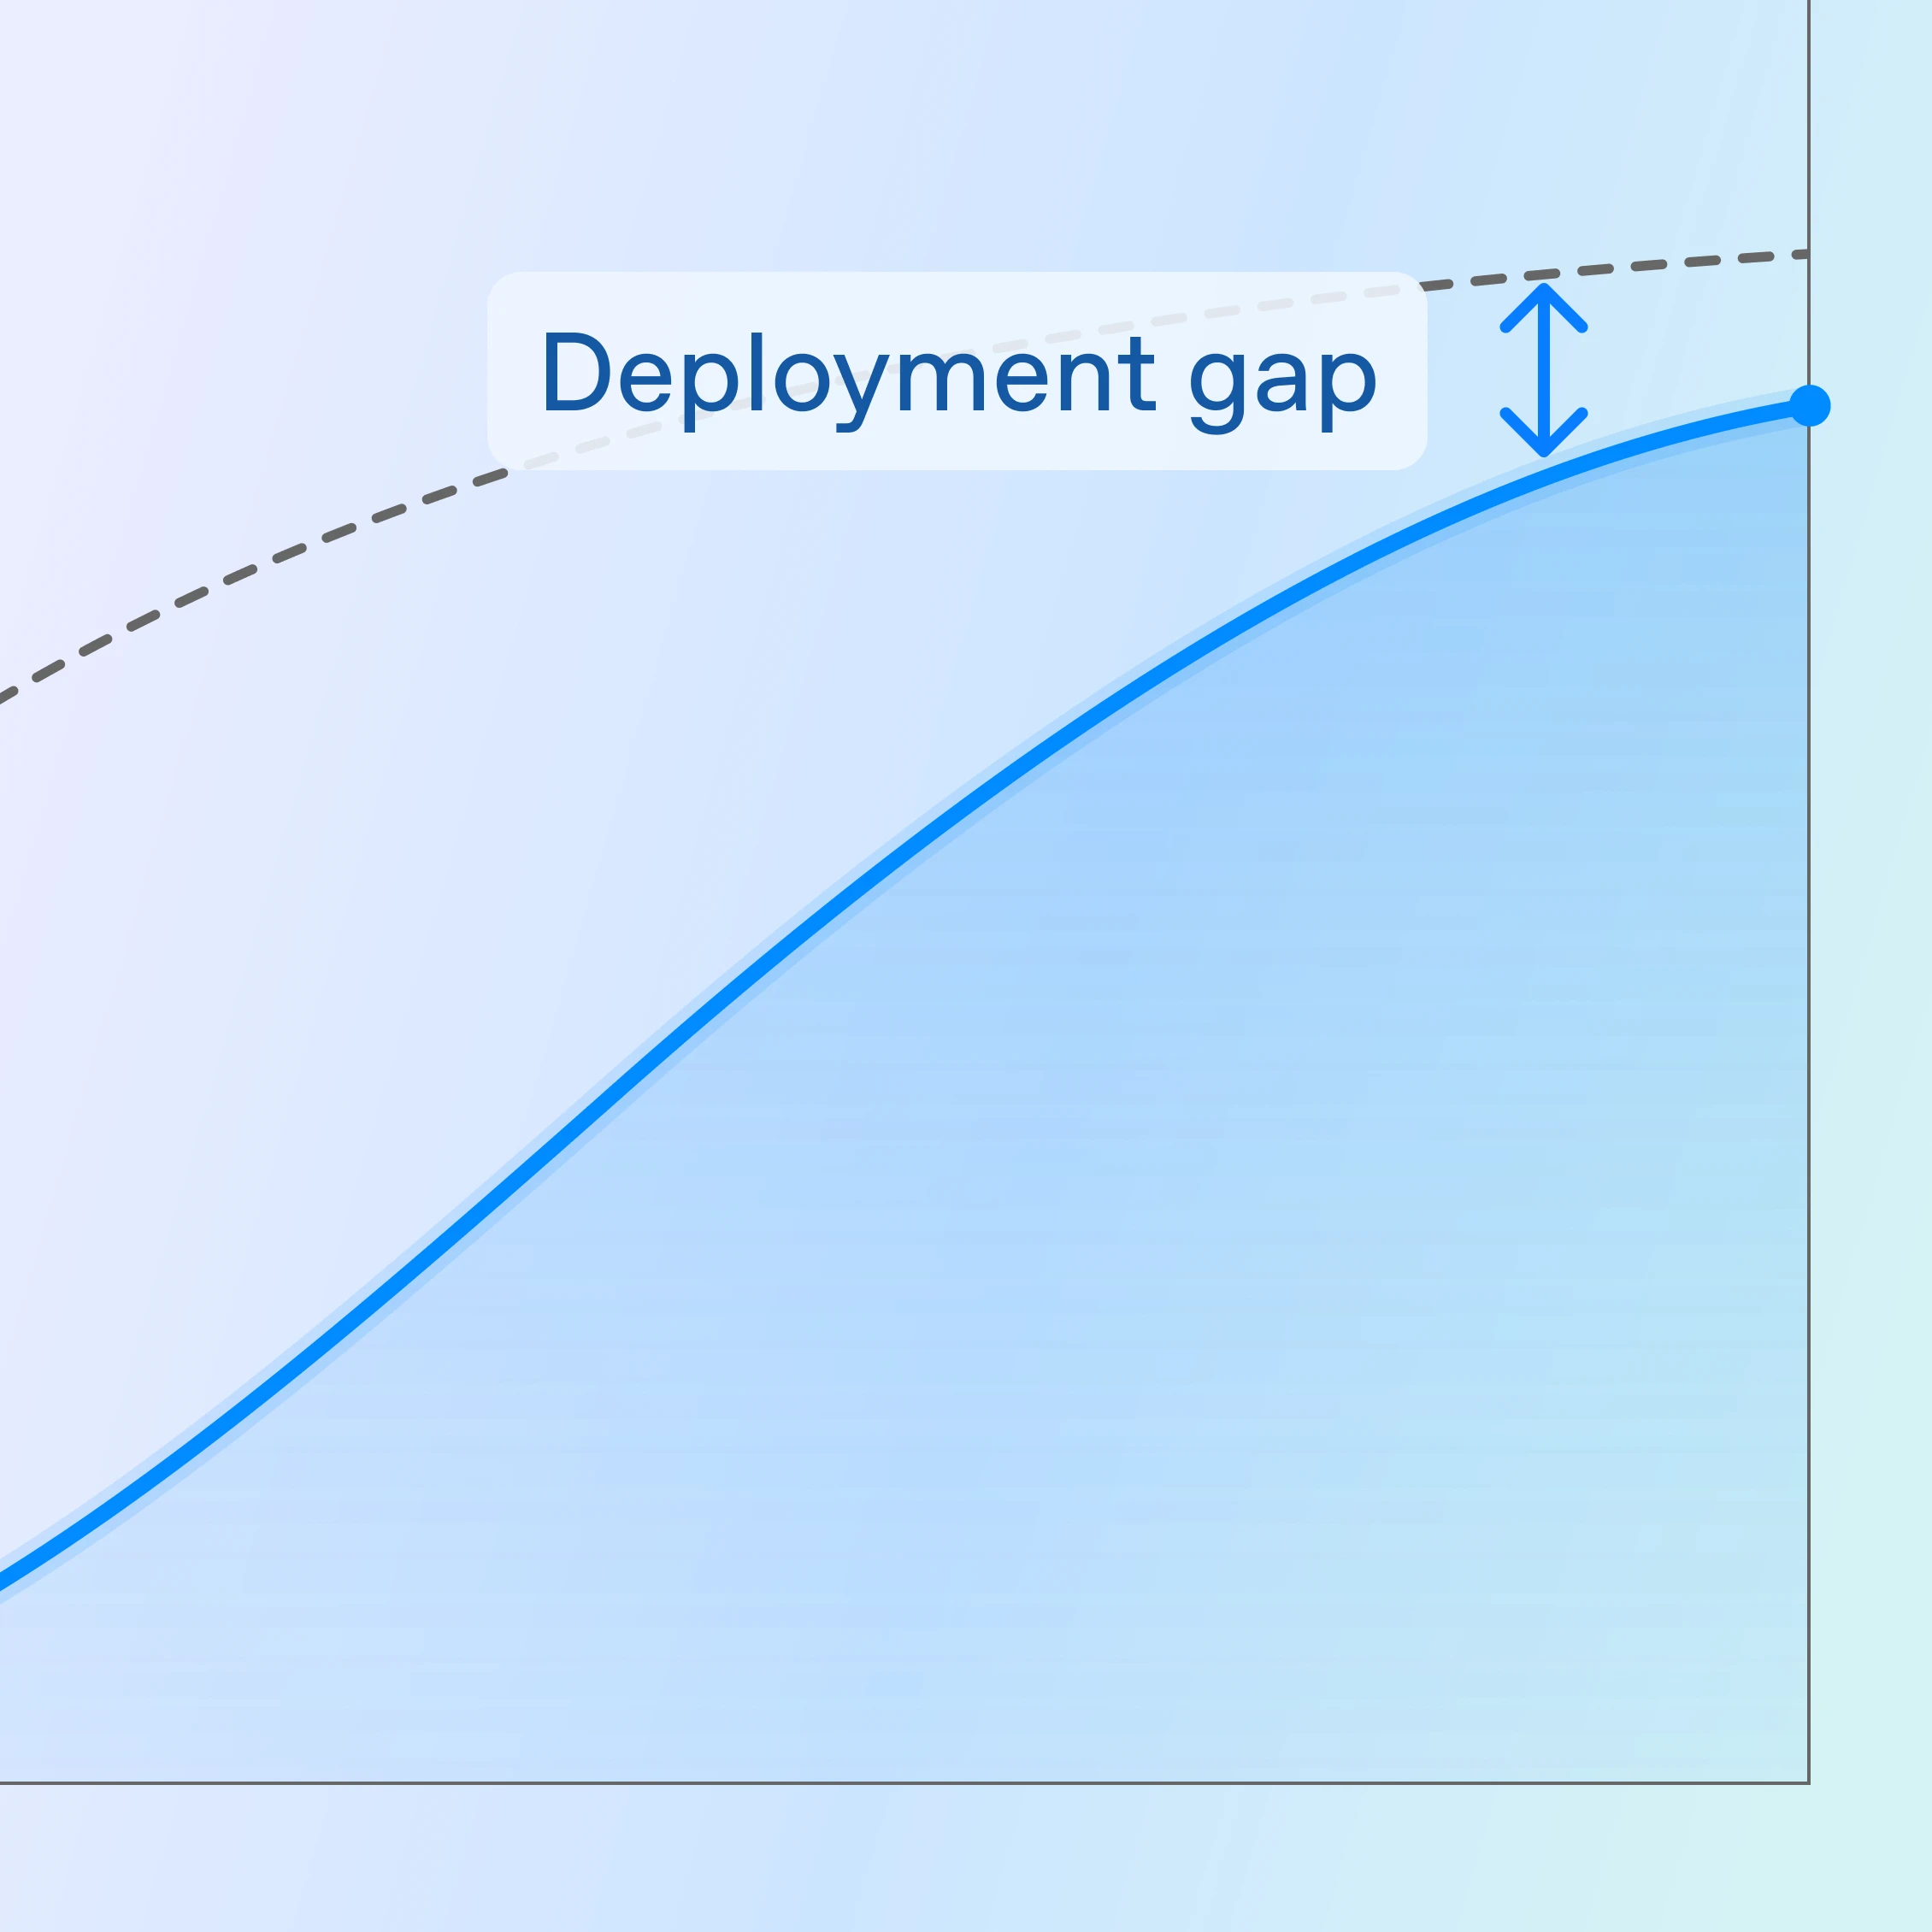
Kopējo izmaksu efektivitāti papildina lielāka precizitāte ar mazāku spriestspējas piepūli. Piemēram, testā Agents’ Last Exam GPT‑5.6 Sol ar “zemu” spriestspējas piepūli pārspēja GPT‑5.5 ar “augstu” piepūli, izmantojot nemainīgu izpildes ietvaru. Līdzīgus panākumus esam novērojuši produkcijas vides testos: jaunuzņēmumi ziņo par ievērojamu izmaksu samazinājumu dažādās darbplūsmās, pazeminot spriestspējas piepūli salīdzinājumā ar iepriekšējiem noklusējumiem.
Vēsturiski ilgstošiem lietojumiem labākā izvēle ir bijusi pāreja uz pamatmodeli ar augstāko pieejamo spriestspējas līmeni. Tas lielā mērā skaidrojams ar šo modeļu ievērojami labāko spēju apstrādāt garāku kontekstu un izsaukt rīkus salīdzinājumā ar izmaksām optimizētiem modeļiem. Līdz ar 5.6 saimi tas ir mainījies: ar lielāku skaitļošanas jaudu testa laikā Luna un Terra bieži spēj līdzināties GPT‑5.4 un 5.5, vienlaikus maksājot ievērojami mazāk.
Apskatīsim BrowseComp uzdevumus — meklēšanā balstītu etalontestu, kas pārbauda modeļa spēju atrast grūti atrodamus faktus. Pirms trim mēnešiem GPT‑5.5 (Ļoti augsts) šajā etalontestā ieguva 84,36%, kopējām izmaksām sasniedzot 33,27 ASV dolārus. Izlaišanas brīdī GPT‑5.6 Luna (Ļoti augsts) nodrošina būtībā tādu pašu veiktspēju — 84,04% par 1,33 ASV dolāriem. Kopš tā laika cenas esam samazinājuši vēl vairāk. Uzziniet vairāk par mūsu jaunākajiem cenu samazinājumiem.
Mazākie 5.6 saimes modeļi ir īpaši piemēroti lielas noslodzes darbiem, pret aizkavi jutīgai mijiedarbībai un atkārtotām darbībām aģentu darbplūsmās. Piemēram, ja vadāt juridisko tehnoloģiju jaunuzņēmumu, kas pirms aģenta veiktas analīzes apstrādā ar roku rakstītas piezīmes, vairs nav jāizmanto robežšķirtnes modelis visam procesam — datu izgūšanai varat izmantot Terra vai Luna un būtiski ietaupīt.
Papildus GPT‑5.6 sākotnējās veiktspējas uzlabošanai mēs Responses API ieviesām arī jaunus pamatmehānismus turpmākiem ieguvumiem. Mēs pilnībā apmācījām GPT‑5.6 ar trim savstarpēji papildinošiem arhitektūras risinājumiem, kas aģentiem ļauj darboties efektīvāk:
Atkārtoti izmantojiet jau paveikto: saglabājot spriestspēju starp modeļa gājieniem(atveras jaunā logā) un izmantojot iebūvēto konteksta saspiešanu(atveras jaunā logā) ilgstošu sarunu saīsināšanai, modelis spēj saglabāt darba konsekvenci ilgākos uzdevumos, neapjūkot un bez vajadzības atjaunot iepriekšējo kontekstu.
Vajadzības gadījumā sadaliet darbu paralēli: iebūvētā vairāku aģentu orķestrēšana(atveras jaunā logā) ļauj koordinēt vairākus aģentus paralēlās darba plūsmās un ātrāk pabeigt sarežģītus uzdevumus.
Pārceliet determinētu darbu uz kodu: izmantojiet programmatisku rīku izsaukšanu(atveras jaunā logā), lai filtrētu, apkopotu un orķestrētu rīku izvadi ārpus modeļa konteksta loga, modeļa tekstvienības atvēlot spriedumu izdarīšanai un samazinot izmaksas, aizkavi un konteksta degradāciju.
Izmantojot šīs iespējas kopā, atšķirība var būt krasa. Piemēram, ARC-AGI-3 testā GPT‑5.6 Sol ar standarta izpildes ietvaru ieguva 13,3%. Taču pēc saglabātās spriestspējas un konteksta saspiešanas iespējošanas rezultāts pieauga līdz 38,3%, izmantojot aptuveni sešreiz mazāk izvades tekstvienību. Modelis netika mainīts, taču veiktspēja pieauga gandrīz trīskārt. Plašāku informāciju skatiet mūsu ARC-AGI-3 izpildes ietvara pētījumā.
Aģentu darbplūsmās bieži ir divu veidu darbs:
Uzdevumi, kuros jāizdara spriedumi
Darbs, kas galvenokārt ietver datu pārvietošanu, filtrēšanu un apvienošanu
Kad aģents izgūst 100 pārskatus, filtrē tos pēc datuma un atrod attiecīgos darījumus, modelim nevajadzētu savā konteksta logā analizēt katru starprezultātu. Programmatiska rīku izsaukšana ļauj GPT‑5.6 rakstīt JavaScript kodu, lai orķestrētu rīkus, paralēli veiktu neatkarīgus izsaukumus un apstrādātu to izvadi ārpus konteksta loga. Tādējādi modelis var koncentrēties uz to, kam vajadzīgs intelekts: spriedumu izdarīšanu.
Sarežģītos, paralēli izpildāmos uzdevumos darbību un spriestspējas sadalīšana starp vairāku aģentu darba plūsmām ļauj uzdevumu pabeigt ātrāk un paaugstina domāšanas līmeni. Šādās sistēmās galvenais aģents orķestrē apakšaģentus un deleģē tiem uzdevumus. Apakšaģenti paralēli īsteno savus mērķus un beigās nodod rezultātus galvenajam aģentam galīgajai sintēzei. Komandas var sākt izmantot iebūvēto vairāku aģentu funkcionalitāti, Responses API iespējojot vairākus aģentus(atveras jaunā logā). Šādi darbojas arī ChatGPT spēju iestatījums Ultra.
“Qualia izmanto aģentu komandas atvērtiem pētniecības uzdevumiem, un GPT‑5.6 Sol vienkārši nostrādāja. Tas uzrādīja ievērojamu uzlabojumu salīdzinājumā ar GPT‑5.5, darbu pabeidza ātrāk par gandrīz visiem pārējiem mūsu pārbaudītajiem modeļiem un drīz kļuva par mūsu iecienītāko OpenAI modeli.”
“GPT‑5.6 ir labākais OpenAI orķestrators, ko esam redzējuši. Mēs tam vienlaikus uzdevām sešas specifikācijas — tās visas bija jāraksta, jāizstrādā un jāizskaidro —, un tas spēja izsekot visam, nezaudējot kvalitāti.”
Lai gan GPT‑5.6 labi nosaka piemērotu apakšaģentu skaitu un brīdi, kad tos izveidot, vairāku aģentu darbību var viegli vadīt. Norādot modelim, kad izsaukt apakšaģentus, var palielināt iespēju, ka aģenti tiks izveidoti tikai tad, kad papildu tekstvienību patēriņš nodrošinās labāku veiktspēju.
Visā modeļu saimē uzvedņu kešatmiņas glabāšanas laiks ir pagarināts vismaz līdz 30 minūtēm, un tagad modeļa konteksta logā var determinēti iestatīt kešatmiņas kontrolpunktus. Tas ir ļāvis jaunuzņēmumiem ievērojami palielināt kešatmiņas trāpījumu īpatsvaru.
Papildus kešatmiņas kontrolpunktu iestatīšanai piemērotas prompt_cache_key(atveras jaunā logā) turpmāka izmantošana palielina iespēju, ka pieprasījumi nonāks tajā pašā inferenču dzinī, kas iepriekš apstrādāja tādu pašu prefiksu, tā samazinot aizkavi.
Šie piemēri īpaši skaidri parāda, cik ļoti ir mainījusies aģentu izstrādes ekonomika.
Lietojumi, kuros agrāk katrā posmā bija vajadzīgs robežšķirtnes modelis, tagad var sasniegt līdzvērtīgus vai labākus rezultātus par daudz zemākām izmaksām, izmantojot mazākus modeļus, pielāgojot spriestspējas piepūli un izvēloties efektīvus arhitektūras risinājumus.
Ar nepacietību gaidām, ko jūs radīsiet!
- 2026
- API platforma
Par autoriem
Šo ceļvedi izstrādāja Samarth Madduru(atveras jaunā logā), Prashant Mital(atveras jaunā logā), Dave Leo(atveras jaunā logā) un Julien Reiman(atveras jaunā logā), balstoties uz pieredzi ciešā sadarbībā ar jaunuzņēmumiem, kas veido risinājumus ar GPT‑5.6 — no agrīnas testēšanas līdz produkcijas videi.