Vi introducerar GeneBench-Pro
Ett benchmark på forskningsnivå som mäter hur AI-agenter hanterar tvetydighet och gör viktiga bedömningar i beräkningsbiologi.
Vetenskapliga data kommer sällan med instruktioner. Forskare måste avgöra om ett mönster speglar biologi eller brus, om data kan stödja frågan som ställs och hur varje resultat bör påverka nästa steg. AI-agenter blir allt bättre på att utföra komplexa analyser, men verklig forskning kräver inte bara faktaminne eller fasta arbetsflöden, utan också denna typ av högre omdömen.
I dag introducerar vi GeneBench-Pro – ett utmanande benchmark på forskningsnivå som testar om Modeller klarar den omdömestunga analys som verklig beräkningsbiologi kräver. Det bygger vidare på GeneBench(öppnas i ett nytt fönster) och omfattar svårare, mer realistiska uppgifter inom genomik, kvantitativ biologi och translationell medicin, med den komplexitet, iteration och tvetydighet som präglar forskning i beräkningsbiologi.
Hittills har det funnits få övertygande bedömningar av de systemnivåbeslut som gör verklig beräkningsforskning svår. Det handlar om att hantera tvetydighet, ompröva antaganden, välja rätt analysväg och veta när ett resultat är redo för beslut. Eftersom dessa färdigheter är svåra att formalisera är de också svåra att utvärdera rigoröst, samtidigt som brister i dem allt oftare begränsar AI:s samlade prestanda.
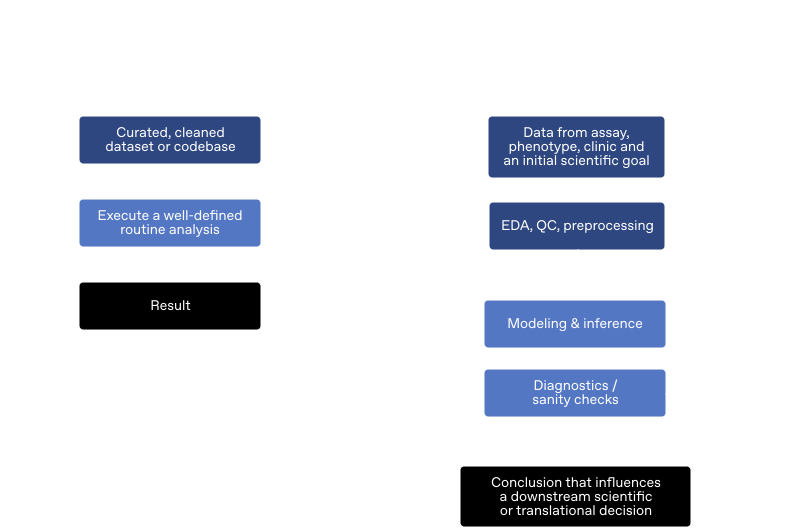
GeneBench-Pro är utformat för att mäta dessa förmågor på högre nivå med precision. I GeneBench-Pro definierar vi ”forskningskänsla” som de kedjor av omdömesbeslut som formar en analys: vilka frågor data kan stödja, hur tidig diagnostik bör ändra Modellen eller estimandet och när en första plan behöver revideras. Varje GeneBench-Pro-problem ger Modellen ett realistiskt och rörigt dataset, kort experimentell kontext och ett målestimand kopplat till ett senare beslut. För att svara rätt måste Modellen utforska data, välja en lämplig analysmetod, arbeta iterativt med experiment och lämna ett slutligt svar.
Inom biologin har kostnaden för datagenerering (t.ex. genomsekvensering) fallit kraftigt, och vissa forskare hävdar nu(öppnas i ett nytt fönster) att flaskhalsen inte längre är provinsamling utan efterföljande beräkning och analys. GeneBench-Pro är byggt för att mäta framsteg mot den flaskhalsen, med 129 frågor som täcker många miljöer och metoder inom beräkningsbiologi.
Domänatlas: 129 problem i 10 domäner och 21 underdomäner
Klicka på en punkt ovan för att läsa mer om ett riktmärkesproblem.
Denna atlas ger en förhandsbild av bredden i GeneBench-Pro. Besök sidan med fallstudier för att utforska 10 representativa frågor mer ingående.
GeneBench-Pro är också utformat för att undvika vanliga benchmarkmisslyckanden. Många långhorisont-benchmarks i biologi bygger flerstegsfrågor kring röriga historiska dataset, där det kanske inte finns en enda korrekt väg genom analysen. En agent kan välja en försvarbar gräns, medan en annan väljer ett annat men lika försvarbart alternativ, vilket speglar benchmarkskaparens godtyckliga val mer än grundläggande skillnader i modellprestanda. Det motsatta kan också ske: om ett problem är för numeriskt okänsligt kan en Agent göra grundläggande analysfel och ändå få ett godkänt resultat.
För att undvika dessa felmönster byggs varje GeneBench-Pro-problem syntetiskt: vi känner till hela den kausala strukturen och simulerar datagenereringsprocessen direkt. Det gör att vi kan justera varje problems komplexitet, säkerställa att rimliga skillnader i subjektiva analysval ändå ger godkända numeriska resultat och verifiera (genom ablationsstudier) att rimliga men felaktiga analyser misslyckas. Därefter granskar vi problemutkast med detaljerade spåranalyser för att kontrollera informationsläckage och oavsiktliga lösningsvägar. Det ger oss förtroende för att rätt svar beror på rätt analytisk väg, inte på att utnyttja en genväg eller matcha en godtycklig författarpreferens.

Vi skickade 82 av de 129 GeneBench-Pro-frågorna till externa domänexperter, däribland doktorander, postdoktorala forskare, industriforskare och professorer. Granskarna bedömde varje problems realism, om målsvaret var identifierbart och om metoderna och estimatorerna var lämpliga. Återkopplingen användes för att förbättra problemen.
“Problemen jag granskade hade varit utmanande för en doktorand att slutföra utan återkoppling i flera omgångar från en erfaren handledare. Data innehöll tekniska problem och kvalitetskontrollproblem som krävde genomtänkt och reflekterande dataanalys, med medvetenhet om möjliga fallgropar, för att lösas framgångsrikt; det handlade inte bara om att använda en färdig metod på rena och välkuraterade data.”
“Även om dagens Modeller inte tillförlitligt kan köra oberoende analyser från början till slut, skulle de som presterar väl på GeneBench-Pro-problem tydligt kunna hjälpa forskare att fastställa korrekta arbetsflöden och utforska data. Jag kan se hur det skulle förbättra forskningens takt, grundlighet och reproducerbarhet avsevärt.”
Varje GeneBench-Pro-problem är en fristående vetenskaplig analys. Agenter får tillgång till en isolerad Arbetsyta med en kort prompt, datafiler och en standardstack för bioinformatik med Python, vetenskapliga beräkningsbibliotek och grundläggande genomikpaket som PLINK 2.0 (även om problemen inte kräver domänspecifika verktyg).
Eftersom vi kontrollerar hela datagenereringen kan vi deterministiskt bedöma korrekthet mot kända mål och undvika modellvalsvariation och effekter av utförlighet i vanlig rubrikbaserad utvärdering.
Varje problem har också rik metadata, bland annat avsedd analysstruktur, bifogade datafiler, en detaljerad fallstudie på flera sidor och resultat från expertgranskning. Vi släpper 10 representativa GeneBench-Pro-frågor helt som öppen källkod på Hugging Face(öppnas i ett nytt fönster), med ett interaktivt webbgränssnitt för att utforska dem. Slutligen kommer vi inom kort att tillhandahålla en delmängd med 50 frågor till Artificial Analysis(öppnas i ett nytt fönster) för oberoende benchmarkning av tredje part.
Vår starkaste Modell, GPT‑5.6 Sol, når en godkännandefrekvens på 28,7 % vid högsta Resonemangsnivå (31,5 % med Pro-läget aktiverat). Det är en kraftig ökning jämfört med när vi började bygga det ursprungliga GeneBench; då fick vår bästa banbrytande Modell, GPT‑5, under 5 %. Framstegen på detta benchmark tyder på att banbrytande Modeller förbättras snabbt, även inom mindre konkreta, systemnivåbaserade vetenskapliga Resonemang. I nuvarande takt kan detta benchmark vara mättat vid årets slut.
Resultaten visar också effekten av att skala upp beräkning vid testtid. På den lägsta resonemangsnivån når GPT‑5.6 Sol bara en ensiffrig godkännandefrekvens. På den högsta resonemangsnivån löser GPT‑5.6 Sol nästan sex gånger så många frågor som GPT‑5.2 och använder samtidigt ungefär två tredjedelar så många Token.
Jämförelser mellan Modellfamiljer tyder på att GPT‑Modeller hör till de starkaste systemen för vetenskapliga Resonemang på hög nivå under kvantitativ osäkerhet. Prestandagapet mellan GPT‑5.6, GPT‑5.5 och ledande Modeller med öppen källkod som GLM 5.2 är betydligt större än vi skulle vänta oss vid extrapolering från kodningsbenchmarks(öppnas i ett nytt fönster), vilket tyder på att öppna Modeller är mer specialiserade för kodning än för bredare Resonemangsförmåga.
Vi använde banbrytande GPT‑Modeller för att utvärdera och förstärka problemen under utvecklingen. Därför misstänkte vi att GeneBench-Pro kunde vara snedvridet mot GPT‑Modeller jämfört med andra Modellfamiljer. KonkurrentModeller matchade dock i bästa fall prestandan hos motsvarande GPT‑Modell vid lansering och låg ofta klart efter.
Dessa utvärderingsresultat – upp till 31,5 % för GPT‑5.6 Sol (Pro) – är slående med tanke på hur svåra GeneBench-Pro-frågorna är. I en enkät uppskattade våra granskare att ett typiskt GeneBench-Pro-problem skulle ta en mänsklig expert omkring 20–40 timmar att slutföra. Med en försiktig uppskattning på 200 dollar per timme innebär det att arbetskostnaden för en människa för ett enda problem hamnar på tusentals dollar. Dagens AI-agenter är fortfarande för opålitliga för att ersätta mänskliga experter, men kostnadsgapet är stort, med inferenskostnader på bara några dollar per problem. Det betyder att även partiell automatisering med dagens förmågor kan skapa betydande ekonomiskt och vetenskapligt värde.
“Referensmätningarna motiveras av en bred uppsättning biologiska frågor, men … den verkliga utmaningen ligger i explorativ dataanalys och Resonemang kring dessa upptäckter: att identifiera mönster och artefakter och avgöra om data bör uteslutas eller justeras. Det liknar den röriga karaktären hos verkliga biologiska dataset. Granskningen av dessa utvärderingar visar hur viktiga tydliga lösarkontrakt är för Agent-baserad vetenskaplig problemlösning. Olika formuleringar av prompten eller uppgiftsspecifikationen kan i hög grad påverka vilka analyser som framstår som tillåtna.”
“Jag gillade [frågorna] för det mesta. De brukade innehålla en blandning av: (1) nödvändig ämneskunskap, till exempel C>T-bias i gammalt DNA, (2) avvikelser i data, till exempel byten av härkomst, (3) viss kunskap om rätt analysverktyg för uppgiften och hur de ska implementeras. Det verkade som om de flesta agenterna misslyckades på (2). De är inte tillräckligt försiktiga med dataproblem. Kanske visar det på en svaghet hos dagens Modeller. Och mycket biologiska data innehåller oregelbundenheter.”
Samtidigt visar det faktum att banbrytande Modeller fortfarande löser mindre än en tredjedel av dessa problem att det finns stor förbättringspotential. Modeller kan göra delvisa framsteg i svåra problem, men har svårt att sluta den inferentiella loopen. Detta felmönster speglar skillnaden mellan mänskliga experter och nybörjare. Experter använder sin erfarenhet för att rama in problemet och anpassa sin metod, medan nybörjare gör observationer men har svårt att integrera dem i problemets bredare sammanhang.
För att nå nästan perfekt prestanda krävs utvärderingar som både mäter framsteg tillförlitligt och visar var Modeller fortfarande misslyckas. Benchmarks som GeneBench-Pro kan hjälpa till att göra en vag förmågebrist till något vi kan diagnostisera och förbättra.
Om agenter tillförlitligt kan automatisera denna typ av analys kan de kraftigt påskynda vetenskapliga upptäckter. Humangenetiska belägg är redan centrala för målprioritering och translationell uppföljning, eftersom mekanismer med genetiskt stöd har mycket större chans att leda till godkända behandlingar.
Samtidigt har sekvenseringskostnaderna rasat, och dataset i biobanksskala kopplar nu molekylär, fenotypisk och journalbaserad information med oöverträffad bredd. Den begränsande faktorn flyttas från datagenerering till att omvandla informationen till handlingsbara insikter. Modeller som konsekvent kan utföra analyser som i dag hanteras av team av mänskliga experter kan förändra industriell forskning genom att påskynda hypotestriage, måluppföljning och iterationscykeln mellan datagenerering och beslut.
GeneBench-Pro är ett första försök att utvärdera de mer abstrakta färdigheter som ingår i gott vetenskapligt omdöme hos erfarna forskare. Dessa färdigheter gör att de kan intuitivt hitta de mest lovande första analyserna, iterera och ompröva sitt tänkande när data motsäger första antaganden och nå slutsatser som senare kliniska, akademiska eller affärsmässiga beslut kan bero på.
Vi räknar med att benchmarks som prövar Modellernas förmåga på dessa högre abstraktionsnivåer blir allt mer användbara i takt med att Modellernas förmågor utvecklas, bortom tester som bara mäter bokkunskap eller förmågan att utföra rutinanalyser.


