Посібник із розробки на GPT‑5.6
Технічні уроки стартапів із виробничого середовища
Сімейство моделей GPT‑5.6 робить продуктивність агентів рівня передових моделей значно доступнішою, водночас розширюючи межі можливого.
У цьому посібнику ми показуємо, як стартапи завдяки розумнішому вибору моделей і новим засобам керування API забезпечують безперервність міркування, багатоагентну оркестрацію та програмне викликання інструментів, щоб швидше створювати потужніших агентів за значно нижчою ціною.
Починаючи з GPT‑5, кожне нове покоління моделей прагнуло виконувати довготриваліші завдання з меншою кількістю токенів. GPT‑5.6 продовжує цей поступ: вища продуктивність агентів і нижчі витрати за мінімальних змін у базовій системі harness.
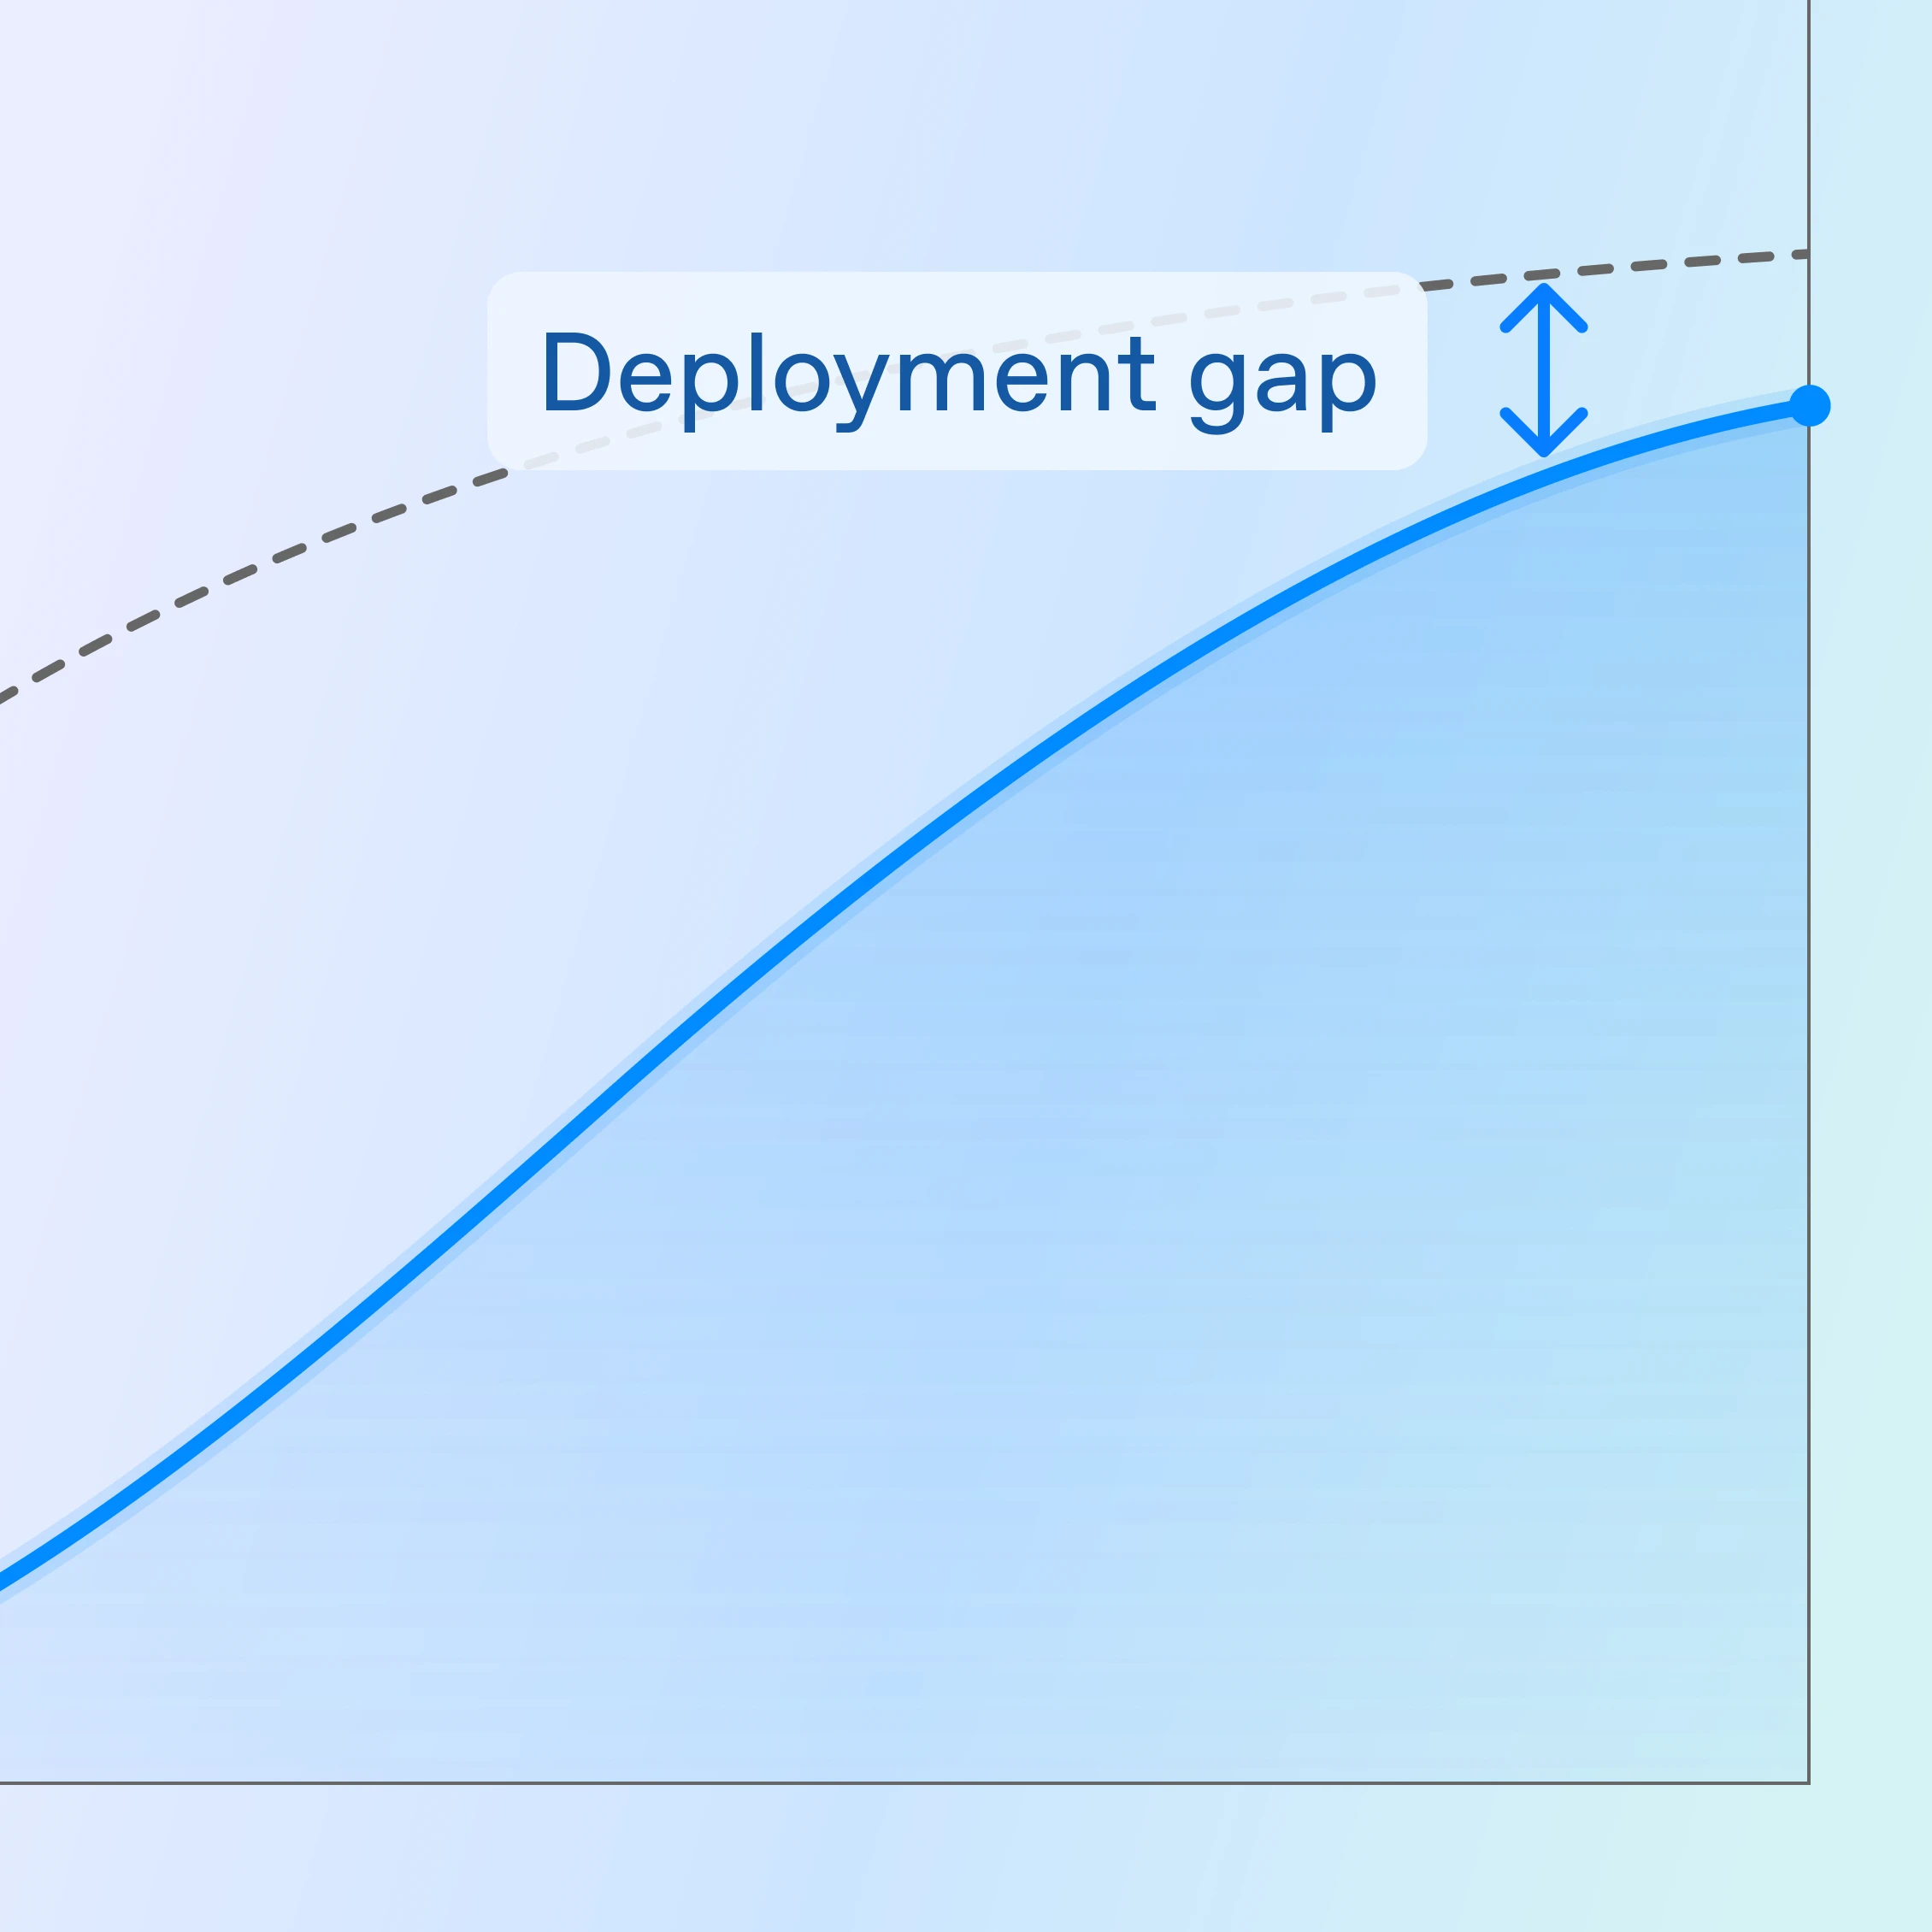
Загальне підвищення економічної ефективності доповнюється більшою точністю за нижчого рівня міркування. Наприклад, в Agents’ Last Exam модель GPT‑5.6 Sol із «низьким» рівнем міркування перевершила GPT‑5.5 із «Високим», коли система harness залишалася незмінною. Ми спостерігали схожі успіхи й у виробничому тестуванні: стартапи повідомляють про значне скорочення витрат у різних робочих процесах завдяки зниженню рівня міркування порівняно з попередніми типовими налаштуваннями.
Історично для довготривалих сценаріїв найкращим варіантом був перехід на флагманську модель із найвищим доступним рівнем міркування. Значною мірою це пояснювалося тим, що такі моделі набагато краще за оптимізовані за вартістю моделі працювали з довгими контекстами та викликали інструменти. Із появою сімейства 5.6 ситуація змінилася: завдяки більшим обчисленням під час виконання Luna й Terra часто працюють на рівні GPT‑5.4 і 5.5, але коштують значно дешевше.
Розгляньмо завдання BrowseComp — пошукового тесту, що перевіряє здатність моделі знаходити маловідомі факти. Три місяці тому GPT‑5.5 (Найвищий) набрала в цьому тесті 84,36% за загальної вартості $33,27. На момент запуску GPT‑5.6 Luna (Найвищий) забезпечує практично такий самий результат — 84,04% за $1,33. Відтоді ми ще більше знизили ціни. Докладніше про наше останнє зниження цін.
Менші моделі сімейства 5.6 добре підходять для великих обсягів роботи, взаємодій, чутливих до затримки, і повторюваних етапів агентних робочих процесів. Наприклад, якщо ваш стартап у сфері юридичних технологій розпізнає рукописні нотатки перед агентним аналізом, тепер для вилучення даних можна використовувати Terra або Luna замість передової моделі в усьому процесі й суттєво заощаджувати.
Окрім підвищення базової продуктивності GPT‑5.6, ми додали до API Responses нові базові механізми для подальшого покращення результатів. Ми наскрізно навчили GPT‑5.6 із трьома взаємодоповнювальними архітектурними механізмами, що дають агентам змогу працювати ефективніше:
Повторне використання вже виконаної роботи: завдяки збереженню міркування(відкривається у новому вікні) між ходами моделі та вбудованому ущільненню(відкривається у новому вікні) тривалих розмов модель може зберігати послідовність роботи над довготривалими завданнями, не заплутуючись і не відновлюючи попередній контекст.
Паралельна декомпозиція, де це доречно: вбудована багатоагентна оркестрація(відкривається у новому вікні) дає змогу координувати кількох агентів у паралельних напрямах роботи й швидше виконувати складні завдання.
Перенесення детермінованої роботи в код: програмне викликання інструментів(відкривається у новому вікні) дає змогу фільтрувати, агрегувати й оркеструвати результати інструментів поза лімітом контексту моделі, залишаючи токени моделі для оцінювання та зменшуючи витрати, затримку й деградацію контексту.
Спільне використання цих можливостей може кардинально змінити результат. Наприклад, в ARC-AGI-3 модель GPT‑5.6 Sol набрала 13,3% зі стандартною системою harness. Однак після ввімкнення збереженого міркування та ущільнення показник зріс до 38,3% — із приблизно вшестеро меншою кількістю вихідних токенів. Модель не змінилася, а результат зріс майже втричі. Докладніше читайте в нашому дослідженні системи harness для ARC-AGI-3.
Агентні робочі процеси часто охоплюють два види роботи:
Завдання, що потребують оцінювання
Робота, що переважно полягає в переміщенні, фільтруванні й об’єднанні даних
Коли агент отримує 100 звітних документів, фільтрує їх за датою та визначає релевантні транзакції, модель не повинна аналізувати кожен проміжний результат у межах свого ліміту контексту. Програмне викликання інструментів дає GPT‑5.6 змогу писати JavaScript для оркестрації інструментів, паралельно виконувати незалежні виклики й обробляти їхні результати поза лімітом контексту. Завдяки цьому модель зосереджується на тому, що потребує інтелектуальних можливостей: на оцінюванні.
У складних завданнях, які можна розпаралелити, розподіл дій і міркування між кількома потоками роботи агентів пришвидшує виконання та підвищує інтелектуальні можливості системи. У таких конфігураціях основний агент оркеструє субагентів і делегує їм завдання. Субагенти паралельно виконують свої завдання, а потім передають результати основному агенту для остаточного узагальнення. Команди можуть одразу скористатися вбудованою багатоагентною роботою, увімкнувши багатоагентний режим(відкривається у новому вікні) в API Responses. Саме так працює й налаштування можливостей Ultra у ChatGPT.
“Qualia залучає команди агентів до відкритих дослідницьких задач, і GPT‑5.6 Sol одразу нам підійшла. Вона помітно перевершила GPT‑5.5, виконала завдання швидше за майже всі інші протестовані нами моделі й швидко стала нашою основною моделлю OpenAI.”
“GPT‑5.6 — найкращий оркестратор, який ми бачили від OpenAI. Ми одночасно дали їй шість специфікацій — попросили написати, реалізувати й обговорити кожну — і вона нічого не втратила з поля зору та зберегла якість.”
Хоча GPT‑5.6 добре визначає доречну кількість субагентів і момент їх запуску, багатоагентною поведінкою легко керувати. Вказівки моделі щодо того, коли залучати субагентів, підвищують імовірність їх запуску лише тоді, коли додаткові витрати токенів справді покращать результат.
Для всього сімейства моделей TTL кешу промпту збільшено щонайменше до 30 хвилин, а контрольні точки кешу тепер можна детерміновано задавати в межах ліміту контексту моделі. Завдяки цьому стартапи змогли значно підвищити частку влучань у кеш.
Окрім налаштування контрольних точок кешу, подальше використання відповідного ключа prompt_cache_key(відкривається у новому вікні) підвищує ймовірність спрямування запиту до того самого рушія інференсу, який раніше обслуговував такий самий префікс, і в такий спосіб зменшує затримку.
Усі ці приклади наочно показують, наскільки змінилася економіка створення агентів.
Сценарії, у яких раніше на кожному етапі була потрібна передова модель, тепер можуть забезпечувати порівнянні або кращі результати за значно нижчою ціною завдяки меншим моделям, налаштуванню рівня міркування та ефективним архітектурним рішенням.
Нам не терпиться побачити, що ви створите!
- 2026
- Платформа API
Про авторів
Цей посібник підготували Самарт Маддуру(відкривається у новому вікні), Прашант Мітал(відкривається у новому вікні), Дейв Лео(відкривається у новому вікні) та Жульєн Райман(відкривається у новому вікні) на основі досвіду тісної співпраці зі стартапами, що створювали рішення на GPT‑5.6 — від раннього тестування до виробничого запуску.